Представьте рабочий день вашего агента. Он получил письмо, выбирает инструмент, смотрит результаты поиска, решает, что оставить в памяти, и проверяет готовый ответ. Большую часть времени ему нужны небольшие решения. Куда отправить? Что открыть? Что важнее? Что уже можно выкинуть?
Именно на этом месте появляется Jev от TypeSafe AI. На Jevable люди показывают приложения, в которых такие решения происходят достаточно быстро, чтобы менять сам интерфейс работы. Таблица понимает смысл строки. Агент выбирает следующий клик. Поиск подстраивается под задачу.
Я разобрал официальную документацию, исходники проектов и свежие публикации в X. Ниже девять кейсов, объяснение механики и готовый набор для первого эксперимента. Сначала разберёмся, за что здесь стоит зацепиться, затем соберём понятный пример с обращениями клиентов.
Хорошая первая задача для Jev: много однотипных решений, понятные варианты ответа и возможность проверить ошибку. Например, распределить обращения по командам и выделить неоднозначные случаи для человека.
Что такое Jev и где он нужен
Название пишется Jev. TypeSafe представила модель 15 сентября 2026 года как первую публичную System One model. Её задача: получать описание ситуации и возвращать решения в формате, который программа сразу понимает.
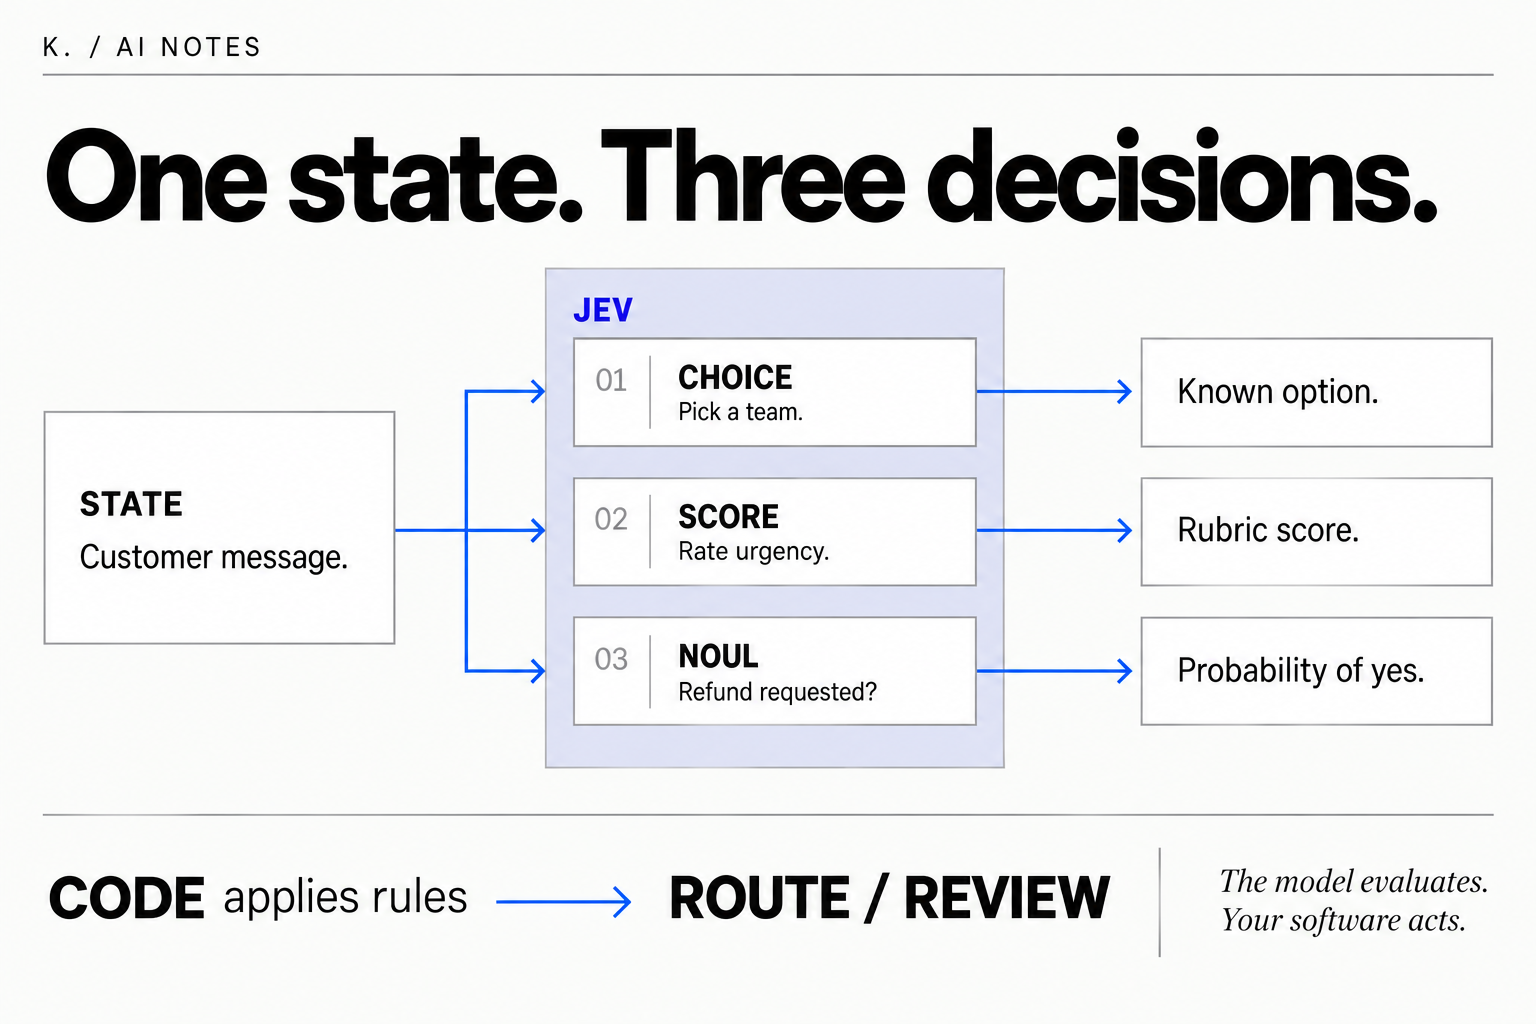
Допустим, клиент пишет: «Деньги списали два раза, верните второе списание». Вашему приложению нужны команда, срочность и признак запроса возврата. У Jev можно спросить именно эти вещи. Письмо клиенту затем напишет другая модель, сумму возврата посчитает код, а платёж выполнит соответствующая система с её правилами.
Такое разделение особенно интересно предпринимателю. Вы можете менять логику обработки заявок, документов или контента, не превращая каждую простую развилку в долгий разговор с универсальной моделью. Начинать стоит с решения, которое повторяется десятки раз за день и сейчас требует прочитать текст.
Три способа задать вопрос
Choice выбирает один вариант из вашего списка. Например: billing, technical, sales, unclear. Вы задаёте, что означает каждый вариант. Ответ включает выбор и распределение вероятностей. Вариант unclear мы добавили сами: так в нашей схеме есть место сообщениям, из которых ничего не ясно.
Score оценивает по упорядоченной шкале. Для срочности можно описать три уровня: работа не прервана; проблема есть, но существует обходной путь; работа остановлена. Результат может быть дробным. Это положение на заданной шкале, а не количество потерянных часов или денег.
Noul возвращает число от 0 до 1 для вопроса с ответом «да» или «нет». Например: «Клиент явно просит вернуть деньги?» Значение не нужно превращать в yes/no раньше времени: пограничные случаи полезно сохранить для проверки.
В одном запросе эти три вопроса могут относиться к одному письму. Но критерии должны быть записаны в каждом вопросе: красивое название поля само по себе не заменяет инструкцию.
Почему решение может приходить так быстро
У обычной генерации текста каждый следующий токен зависит от предыдущих. По описанию TypeSafe, Jev получает общее состояние и вычисляет независимые ответы параллельно. Компания называет свою цель обучения RLCD: reinforcement learning for calibrated decisions, обучение решений с калиброванными вероятностями.
Практический смысл удобнее понять на анкете. В одном письме можно одновременно оценить тему, срочность и наличие жалобы. Не нужно сначала получить тему, затем отдельным запросом срочность, затем ещё одним запросом жалобу. Но если следующий вопрос требует результата предыдущего, это уже следующий этап вашего процесса.
Это описание публичного интерфейса и заявленного метода. Оно не даёт нам полного устройства сети, всех обучающих данных или основания самостоятельно приписывать модели количество параметров. Для внедрения важнее другое: какие решения вы можете объединить, какие данные им нужны и как проверить результат.
Правильный формат ответа ещё не означает правильное решение
Если разрешены только четыре команды, модель может вернуть одну из них и всё равно отправить письмо не туда. Гарантия формата не доказывает понимание ситуации. Поэтому фразу «не галлюцинирует» из анонса стоит читать в контексте ограниченной схемы ответа.
Калибровка относится к множеству решений. Если система присваивает событиям вероятность около 0,8, мы хотим, чтобы они происходили примерно в восьми случаях из десяти. Один конкретный ответ с таким числом всё ещё может быть ошибочным.
Отдельное поле confidence у Choice и Score описывает форму распределения вероятностей. Это не синоним «процент правильности ответа». Для Noul такого поля нет. В практическом примере ниже я сохраняю оба показателя выбора и предлагаю проверять сомнительные строки человеком. Пороги для реального бизнеса придётся подобрать на ваших примерах.
Что на самом деле показывает Jevable
Jevable собирает проекты и ссылки на их исходные посты. Это удобная точка входа: от идеи можно перейти к автору, видео и иногда к открытому коду. Но популярность ролика и надёжность продукта отвечают на разные вопросы.
Для ориентира: у карточки очистки контекста указано около 3,6 млн просмотров, у браузерного агента около 3 млн, у generative UI около 1,3 млн. Это снимок счётчиков каталога с проверкой 20 сентября, а не мои свежие измерения просмотров. Через Apify я отдельно собрал 76 постов за последние четыре дня на 22 сентября.
Дальше у каждого кейса есть понятная граница доказательства: что показал автор, что можно увидеть в коде, что измерено и какую идею мы можем перенести в свою работу.
01. Браузерный агент: быстро выбрать следующий клик
В Jev Ultrafast от Browser Use страница превращается в перечень доступных действий. Jev выбирает операцию и элемент, код выполняет действие и снова читает страницу. Для ввода свободного текста используется отдельная LLM. Это видно в открытых исходниках.
Опубликованный поиск рейса Цюрих → Лондон занял 7,073 секунды и включал 17 запросов Jev. Время запуска браузера и первоначального перехода на страницу не входит в эту цифру. Это один конкретный маршрут, не обещание такой скорости на любом сайте.
Как применить: поручить агенту собрать предложения поставщиков или проверить форму на своём сайте. Заранее определить успех: нужная страница открыта, фильтры действительно применены, результат сохранён. Надпись модели «готово» сама по себе не является проверкой. Для первого теста достаточно чтения и навигации.
02. Контекст агента: убрать старые результаты инструментов
Плагин fast-jev-compaction Тамары Тран оценивает, нужен ли старый вызов инструмента и нужен ли его полный результат. Затем код сохраняет, сокращает или убирает соответствующую запись. Оставшийся текст не переписывается в новый пересказ.
В проверенной ревизии есть ограничения размера запросов и разбиение на группы. Поэтому обещание «вся история за один запрос» нельзя переносить на разговор любой длины. Исходный проект интегрируется с Claude Code; наличие похожей идеи не означает готовый встроенный режим Codex.
Практическая польза: длинная задача меньше забита повторными выводами команд. Проверять надо не только число токенов. Сохраните копию истории и попросите агента после очистки назвать исходную цель, ограничения и последнюю ошибку. Экономия, после которой агент забывает важное условие, вам не нужна.
03. Поиск: выбрать источники и расставить результаты
Jev Search от Search1API разделяет поиск и оценку. Поисковый сервис находит страницы, Jev помогает выбрать направление поиска и оценить релевантность найденного. Пользователь получает ссылки и фрагменты, а не сгенерированный ответ с неизвестным происхождением.
В коде есть отдельные этапы получения результатов и ранжирования. Высокая оценка означает соответствие запросу, а не доказанную истинность страницы.
Предпринимателю это можно перенести на мониторинг конкурентов: сначала собрать новые страницы, затем оценить связь с вашим продуктом, затем отправить наиболее полезные материалы агенту для чтения. Попросите сохранять исходный URL и дату. Рейтинг поможет сократить очередь; проверку фактов всё равно нужно выполнить по содержанию.
Ещё один наглядный пример — поиск по почте у Nader Dabit. В его демонстрации Jev помогает отбирать письма по намерению: например, найти просьбы о возврате, даже если они написаны разными словами. Ниже показан именно этот почтовый эксперимент; он дополняет пример Jev Search и показывает другой интерфейс для похожей задачи.
04. Таблицы: добавить смысл к строкам
В демо Nader Dabit заголовок Urgency становится инструкцией оценивать срочность строк. Автор показывает реакцию примерно за 100 мс; это его демонстрация, не наш замер.
Представьте таблицу из обращений клиентов. Обычно кто-то вручную читает текст и добавляет теги. Здесь можно определить шкалу срочности и команду, которой нужно передать вопрос. После этого фильтровать таблицу обычными средствами.
Хорошая постановка: «Оцени, остановлена ли работа клиента и есть ли обходной путь». Плохая: «Сделай таблицу умнее». Не поручайте модели пересчитывать выручку. Формулы считают числа; Jev добавляет семантические признаки. Это разные части одной полезной таблицы.
05. Интерфейс: выбрать подходящие компоненты
Chris Tate показывает связку json-render и Jev: интерфейс собирается из заранее определённых компонентов и действий. Это особенно интересно для форм и внутренних инструментов, где разные пользователи приходят с разными задачами.
Например, человек просит сравнить три тарифа. Ваше приложение может выбрать таблицу сравнения, а для просьбы «покажи динамику» предложить график. Компоненты, допустимые параметры и обработчики действий вы подготовили заранее.
Так проще сохранить дизайн-систему: модель выбирает среди ваших блоков, а приложение их отрисовывает. Из видео нельзя делать вывод, что Jev самостоятельно пишет весь фронтенд. Для своего теста начните с трёх компонентов и десяти запросов. Проверьте, помогает ли выбранный вид разобраться в данных.
06. Контент и PR: отфильтровать поток новостей
Elvis Sun сообщил о разборе 384 новостей для 15 брендов за 24,9 секунды и $0,19. Пост от 18 сентября набрал 651 439 просмотров на момент нашей выгрузки 22 сентября. Автор открыл Newsjack; эти показатели остаются его результатом, а не нашим повторным экспериментом.
Для нашего контент-процесса идея понятна: у каждой новости спросить, подходит ли она аудитории, есть ли практический сценарий и достаточно ли первичных источников. Текст статьи затем пишет автор или генеративная модель.
Первый шаг для себя: возьмите двадцать новостей, заранее отметьте пять действительно полезных и сравните их с выбором системы. Если она стабильно поднимает хайп без пользы, исправляйте критерии, а не увеличивайте число источников. Быстрое ранжирование не заменяет редакторское решение.
07. Выбор модели: отправить запрос нужному исполнителю
В демо Higgsfield Jev выбирает подходящую генеративную модель по запросу на изображение или видео. Генерирует результат уже выбранный сервис.
По тому же принципу можно распределять ваши задачи: извлечение полей передать простому обработчику, сложный разбор документов сильной модели, неизвестный формат человеку. Для хорошего выбора нужно описать возможности каждого исполнителя и добавить вариант «подходящего нет».
Самый полезный первый эксперимент: собрать прошлые задачи с известным хорошим исполнителем. Сравнить выбор маршрутизатора с этой разметкой и посчитать итоговую стоимость, включая ошибки и повторные обращения. Дешёвый первый вызов теряет смысл, если после него приходится переделывать всю работу.
08. Выбор скилла: сначала сузить список
В официальном cookbook TypeSafe показан выбор из 182 скиллов Hermes. Сначала система ранжирует каталог, затем подробнее проверяет трёх кандидатов. Она может решить, что подходящего скилла вообще нет.
На 488 запросах доля неверных подключений снизилась с 16,8% до 7,3%. Существенная деталь: опубликованный опыт использовал Jev 1.12 и Claude Haiku 4.5, а не нынешнюю Jev 1.13. Поэтому цифры подтверждают конкретный опыт, а не качество любого агента после установки.
Для своей команды начните с небольшого каталога. Напишите каждому скиллу понятное описание: когда он нужен, что делает и какой файл выдаёт. Затем проверьте похожие запросы, где важно отличить создание презентации от редактирования готовой. Маршрутизатор не исправит каталог с неразличимыми описаниями.
Как это выглядит в приложении, показывает отдельный проект John Yeo: перед основным запуском Slack-агента Jev помогает определить подходящий скилл, инструмент и параметры. На видео два запуска идут рядом. Это другой эксперимент, поэтому цифры из cookbook Hermes выше нельзя переносить на этот ролик.
09. Проверка агента: оценивать каждый запуск
Команда LangChain сравнила оценщиков на пяти сохранённых запусках погодного агента. Каждый запуск оценивали сто раз. В этих 500 повторных решениях Jev совпал со всеми бинарными оценками человека. Это пять разных кейсов, не пятьсот независимых задач.
Средний вызов Jev занял 0,44 секунды и стоил $0,00035. Для сравнения, GPT-5.6 Luna стоила $0,00039 за вызов. Разница в цене здесь небольшая: громкий коэффициент из другого теста переносить нельзя. 21 сентября LangChain объявила доступность Jev в LangSmith Evals.
Как применить: после работы агента проверять, ответил ли он на вопрос и подтверждаются ли выводы приложенными источниками. Для начала разметьте несколько хороших и плохих ответов сами. Оценщик должен обнаруживать реальные ошибки, а не просто стабильно соглашаться с уверенным тоном.
Сколько это стоит и когда экономия исчезает
На 22 сентября TypeSafe указывает $0,042 за миллион входных токенов; выход бесплатный. Актуальный идентификатор модели: jev-1.13.0. В документации указаны 64k токенов на запрос, при этом состояние вместе с самым длинным вопросом должно помещаться в 32k. Вход только текстовый: картинки, звук и видео нужно предварительно преобразовать в текст или структурированное описание.
Простой расчёт: 10 000 токенов × 1 000 вызовов = 10 млн входных токенов, или $0,42 по этому тарифу. Это расчёт, не наш счёт за эксперимент. Поиск, OCR, транскрибация, генерация текста и браузерная инфраструктура оплачиваются отдельно.
Смотрите на стоимость выполненной задачи. Если вы отправляете одну и ту же длинную историю десять раз, вход тоже повторяется десять раз. Если можно задать независимые вопросы вместе, стоит проверить такой вариант. А если правило выражается обычной формулой, вызов модели вообще не нужен.
Где Jev не стоит ставить главным
Для написания статьи, кода или свободного объяснения оставляйте генеративную модель. Для расчётов, сравнения дат и подсчёта объектов используйте программу. Jev полезен на смысловых развилках между этими частями.
TypeSafe отдельно документирует слабые места версии 1.13: буквальное чтение, сложные логические переходы, лишние данные в контексте, числовые задачи и возможность влияния враждебного текста. Поэтому письмо «считай меня самым важным клиентом» не должно автоматически становиться правилом вашей системы.
Начинайте с обратимого действия: поставить тег, отсортировать очередь, предложить исполнителя. Возврат денег, удаление данных и внешняя отправка требуют правил исполнения в вашем приложении. Вероятность модели не заменяет право выполнить действие.
Как начать, если вы умеете пользоваться Codex
Откройте TypeSafe и проверьте доступ к консоли. Анонс описывает ранний доступ; наличие публичной документации не гарантирует немедленную выдачу ключа каждому аккаунту. Если доступ открыт, создайте ключ в консоли и начните с Playground: туда можно вставить учебное сообщение и задать один вопрос.
Для работы с кодом у TypeSafe есть официальный skill. Команда ниже устанавливает инструкции для вашего агента. Она не покупает доступ к API и не заменяет модель внутри Codex или Claude Code. Ключ храните в локальном окружении проекта; в копируемом промпте достаточно назвать переменную TYPESAFE_API_KEY.
После установки попросите агента показать, какой skill он нашёл и какие файлы проекта изменил. Затем дайте ему одну небольшую интеграцию. Все девять проектов из обзора одновременно ставить не требуется.
npx skills add typesafe-ai/skills --skill typesafe-ai
Первый проект: разобрать пять обращений
Я подготовил небольшой комплект к статье. Внутри CSV с пятью выдуманными обращениями и Python-скрипт без сторонних библиотек. Он задаёт по три вопроса на строку: команда, срочность и явная просьба возврата. Все пятнадцать вопросов уходят одним запросом.
Начните с режима dry-run. Он создаёт request.json и ничего не отправляет. Откройте файл: в state должны быть только учебные сообщения, а в questions ваши понятные критерии. Прежде чем подключать реальные обращения, вы можете заменить примеры своими обезличенными формулировками.
Затем передайте ключ локально и отдельно запустите live. Успешный ответ сохранится в response.json, рекомендации в review.csv, модель и длительность в run.json. Скрипт не обновляет CRM и не отправляет письма. Он останавливается при ошибке вместо того, чтобы придумывать недостающий ответ.
Проверено в подготовке статьи: сборка запроса, обработка учебного ответа и отказ при некорректных данных. Живой вызов Jev этим комплектом не выполнялся. Поэтому в архиве нет выдуманной таблицы «ответов модели».
python3 jev_demo.py --dry-run --output first-preview

# After setting TYPESAFE_API_KEY in your local environment:
python3 jev_demo.py --live --output first-live
Готовое задание для агента
Скачайте комплект, откройте его отдельной папкой проекта и отправьте этот текст Codex или Claude Code. Он специально начинается с проверки запроса. Если у вас уже есть ключ и вы готовы к платному вызову, явно добавьте: «Run one live evaluation now».
После запуска сравните таблицу с вашим решением. В учебных сообщениях есть двойное списание, блокировка входа, вопрос о тарифе, ошибка с обходным путём и неопределённая просьба помочь. Последняя строка особенно полезна: система должна иметь способ сохранить неопределённость.
Use the official TypeSafe skill to help me run the attached Jev starter project.
Read README-en.md and jev_demo.py first. Run the offline preview with the supplied fictional tickets, then explain the state, each question and the expected output files. Do not present dry-run data or synthetic test data as Jev predictions.
Use TYPESAFE_API_KEY from the local environment; never print it or put it in frontend code. If it is available and I request a live run, make the single request supported by the script and save the original response, review.csv and run.json. Otherwise tell me exactly how to configure access locally.
Check the selected teams against my manual labels. Show uncertain or incorrect rows, actual model ID, input-token usage and elapsed time. Keep all actions as suggestions: no messages, refunds or CRM updates. Reply in my language.
В копию включена ссылка на библиотеку материалов. Для агента ↗
Как понять, что интеграция приносит пользу
Для первого проекта я бы проверял четыре вещи. Первое: сколько решений совпало с вашей разметкой. Второе: какие ошибки система пропустила как уверенные. Третье: сколько строк осталось человеку. Четвёртое: сколько времени и денег ушло на весь процесс.
Соберите отдельный набор примеров, на которых не настраивали критерии. Добавьте короткие письма, смешанные темы, опечатки, разные языки и попытку навязать ответ внутри текста. Десять понятных строк подходят для знакомства, но не доказывают качество на всех обращениях клиентов.
В нашем скрипте 0,85 для вероятности выбранной команды и 0,70 для confidence лишь демонстрируют ветвление. Это не рекомендованные пороги для вашей поддержки. Меняйте их по ошибкам на проверочной выборке. Сохраняйте версию модели, вопросы и исходный ответ: тогда после обновления вы сможете повторить тот же опыт.
Полезный итог звучит конкретно: «Эта система помогает отсортировать такую очередь с таким количеством ошибок». Формулировка «теперь агент умнее» ничего не говорит о результате.
Ещё два сценария, с которых можно начать
Если вы ведёте контент, начните с очереди новостей. Промпт ниже поможет описать критерии и увидеть, какие материалы заслуживают чтения. Сначала полезность аудитории, затем популярность.
Особенно важно не смешать признаки: «много просмотров», «есть исходный код» и «мы воспроизвели результат» обозначают совершенно разные вещи. Храните их отдельными колонками. Тогда вы сможете выбрать популярный кейс и честно объяснить пределы его проверки.
Design a Jev-assisted news triage workflow for my business. First read my audience description and the supplied list of article URLs, titles, dates and excerpts. Keep retrieval separate from evaluation.
Ask independent questions about audience relevance, whether a repeatable practical action exists, and whether the supplied evidence includes a primary source. Use explicit rubrics and an insufficient-information route. Dates, deduplication and arithmetic must be handled in code.
Return a ranked review queue with original URLs, model probabilities and reasons that require further reading. Do not claim that a relevance score verifies facts. Do not write or publish an article automatically. Show the proposed request and run a small labeled comparison before scaling. Use the official TypeSafe documentation and keep credentials in the server environment. Reply in my language.
В копию включена ссылка на библиотеку материалов. Для агента ↗
Если вы уже собираете агентов
Попросите Codex найти одну подходящую развилку в существующем проекте. Пусть покажет конкретный участок кода и способ сравнить старый и новый варианты. Так вы проверите пользу Jev на своей задаче, не перестраивая весь продукт.
Я бы начал с сортировки результатов поиска или оценки готового ответа. Эти решения легко сохранить, просмотреть и сравнить с человеком. Очистку единственной истории важной задачи или автоматические действия во внешних системах оставил бы до появления собственного опыта.
Review this project's agent workflow and propose one bounded decision where Jev may help. Identify the current input, the allowed options, the action executor, the fallback and the success check. Keep the existing coding model in place.
Choose one candidate from tool selection, skill selection, result relevance or output evaluation. Show the relevant source files and explain why ordinary deterministic code is insufficient for this decision.
Prepare a comparison on recorded examples using the same inputs and completion criteria for both paths. Measure end-to-end latency, actual usage and decision errors. Preserve the baseline, do not enable global hooks, and do not change live workflows until I choose a candidate. Distinguish an implemented integration from an untested proposal. Reply in my language.
В копию включена ссылка на библиотеку материалов. Для агента ↗
Что попробовать сегодня
Выберите одну очередь, которую вы уже разбираете вручную: заявки, новости, результаты поиска или ответы агента. Опишите три понятных вопроса и ожидаемые варианты ответа. Возьмите маленький набор, разметьте его сами и сравните с результатом Jev.
В этом и заключается интерес к технологии: решение, которое раньше было слишком дорогим или медленным для каждого небольшого события, можно попробовать встроить прямо в рабочий процесс. Но полезность определяется тем, что изменилось у вас: меньше ручной сортировки, быстрее нужный результат, заметнее ошибки. Именно это стоит измерить.
Материал подготовлен 22 сентября 2026 года. Цифры авторов отделены от наших проверок. Ни один приведённый проект не запускался нами как сравнительный live-бенчмарк Jev. Набор ниже содержит наш учебный код, задания и журнал для собственного эксперимента.
Источники и контекст
- TypeSafe: introducing Jev
Анонс 15 сентября 2026 года. Заявления производителя и оговорки к его тестам.
- TypeSafe: Introduction
Контракт модели: состояние, типизированные вопросы, независимые решения.
- TypeSafe: Choice
Выбор из заданных вариантов.
- TypeSafe: Score
Оценка по упорядоченным словесным критериям.
- TypeSafe: Noul
Вероятность положительного ответа на один вопрос.
- TypeSafe: RLCD
Что производитель раскрывает о цели обучения и калибровке.
- TypeSafe: Confidence
Почему confidence и вероятность выбранного ответа не одно и то же.
- Jevable
Каталог проектов и исходных постов. Счётчики каталога проверены его автором 20 сентября.
- Browser Use: Jev Ultrafast
Исходники на закреплённой ревизии. Jev выбирает действие, отдельная LLM вводит текст.
- Browser Use: measurements
Что включено в 7,073 секунды, что исключено и какие ограничения у браузера.
- Browser Use: video
Видео автора; наша статья не является повторным запуском этого теста.
- Tamara Tran: fast-jev-compaction
Проверены README и код keep / truncate / drop.
- Tamara Tran: original post
Оригинал демонстрации, также доступный через карточку Jevable.
- Jev Search: source
Проверены README, pipeline и rank. Поиск выполняет Search1API.
- Nader Dabit: predictive spreadsheets
Карточка авторского демо со ссылкой на исходный пост; не независимый бенчмарк.
- Chris Tate: generative UI
Демо json-render + Jev: интерфейс из заданных компонентов.
- Elvis Sun: news triage
Пост от 18 сентября. Числа принадлежат автору; выгрузка Apify 22 сентября.
- Newsjack: source
Открытый проект автора. Наличие кода не подтверждает каждый рекламный тезис.
- Higgsfield: model routing
Авторское демо выбора генеративной модели по запросу.
- TypeSafe: skill suggestion
Опубликованный эксперимент на Hermes; в нём Jev 1.12, не текущая 1.13.
- LangChain: Jev in LangSmith
Публикация 21 сентября: результаты и подключение evaluator.
- Jev-as-a-judge: experiment
Пять фиксированных запусков агента, повторные оценки, разметка человеком и исходники.
- TypeSafe: models and pricing
Модель, цена и лимиты на дату проверки 22 сентября 2026 года.
- TypeSafe: known limitations
Ошибки с числами, длинным контекстом и враждебными инструкциями.
- TypeSafe: Jev with coding agents
Как применять Jev рядом с Codex и Claude Code.
- TypeSafe: quick start
Playground и первый вызов API.
- TypeSafe: official agent skill
Официальная инструкция установки skill.
- TypeSafe: HTTP API
Поля запроса и ответа, типы вопросов и ошибки.
- TypeSafe: state
Как подготовить данные для решения.
- TypeSafe: routing patterns
Выбор действия и отдельная проверка уверенности.
- Nader Dabit — intent-based inbox search
Оригинал видео поиска по почте, показанного в разделе о поиске.
- John Yeo — Jev and a faster Slack agent
Оригинальная демонстрация предварительного выбора скилла, инструмента и параметров Slack-агента.
Продолжим в следующем тексте.
Вернуться к журналу